Des sujets qui ont attiré mon attention ce mois de septembre.
Avec un particulier :
- Illustration de la course aux données au travers du cas des voitures autonome, Google, Tesla, Waymo.
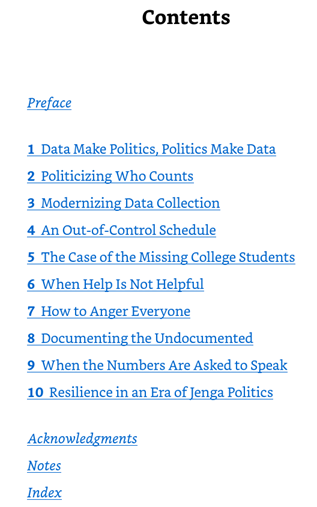
- Le livre de Danah Boyd est paru – une référence – « Data Are Made, Not Found – A Story of Politics, Power, and the Civil Servants Who Saved the US Census ».
- Le corps des défunts, des données aux enjeux économiques, politiques et opérationnels !
Jusqu’où vont se nicher les données. Rien ne les arrête ! - Avant de confier sa mort aux données (voir le sujet précédent), les dangers de confier sa vie aux données…au risque d’être éliminé.
- Quelle est la valeur des données de santé ?
Sinon, une liste de lectures au fil de l’eau.
A piocher en fonction de vos centres d’intérêt.
Sommaire :
- Illustration de la course aux données au travers du cas des voitures autonome, Google, Tesla, Waymo
- Le livre de Danah Boyd est paru
- Le corps des défunts, des données aux enjeux économiques, politiques et opérationnels !
- Avant de confier sa mort aux données (voir le thème précédent), les dangers de confier sa vie aux données…au risque d’être éliminé
- Quelle est la valeur des données de santé ?
- La guerre des données, rôles des data products dans une architecture, Donnée de surveillance, Données de surveillance, Trois types de goulot d’étranglement liés au données, La course à la collecte de données d’entraînement, L’éternel sujet de représentation du temps dans les données, Destruction des data centers … destruction des données, Reconstruire, refondre N fois une data platform au sein d’un S.I, L’Open Data Institute, Sir Tim Berners-Lee et l’ONU lancent une fondation de données, Data physicalisation)
Illustration de la course aux données au travers du cas des voitures autonome, Google, Tesla, Waymo.
La vision simpliste : celui qui a le plus de données, a un avantage considérable, point final.
En réalité on ne parle pas tout à fait des mêmes données.
Avec des stratégies, des questions différentes.
L’article détail cela – quelques éléments :
Tesla : on parle de des données d’apprentissage comportemental, les décisions de conduite (direction, freinage, changement de voie), enregistrées en continu via les propriétaires de Tesla (portée – couverture des données). Mais avec un fort pourcentage autoroutier (monde plus fermé qu’une circulation en ville ou rase campagne).
Tesla a l’avantage en matière de données comportementales contextualisées. Ses voitures collectent des images de caméras, des données sur la direction et toutes sortes de données télémétriques impossibles à obtenir avec un téléphone.
Waymo : on parle de données de conduite sans intervention humaine avec les décisions prises par le système de conduite autonome (y compris les cas d’intervention d’un superviseur corrigeant les décisions ?).
Ces stratégies de données répondent à des questions différentes (aide à la conduite – données des conducteurs, conduite autonome).
Google : Google via Maps puis Waze construit une carte commerciale la plus détaillée possible, mise à jour en temps réel grâce aux données de milliards de téléphones Android/Maps/Waze qui transmettent leur position et leur vitesse (et même les freinages brusques), les signalements des conducteurs en temps réel de Waze. Il ne s’agit pas de données comportementales. Mais ces données fixent un repère pour détecter les changements, le cycliste qui se faufile entre les voitures, la camionnette de livraison qui bloque une voie, le piéton qui traverse soudainement le trottoir.
En termes de stratégie de données, quand Tesla reconstruit les cartes à chaque nouveau déploiement de ces véhicule dans un lieu. Waymo en s’associant avec Google bénéficie d’une cartographie établie.
On le voit sur cet exemple, que la stratégie de données ne se limite pas du tout à un volume de données à atteindre mais à l’alignement entre une finalité et les natures de données associées, à collecter par soi-même ou à aller chercher chez un partenaire… du bon sens.
Source : https://medium.com/truthseeker-journey-to-wisdom/two-kinds-of-data-two-kinds-of-moat-b0fbc4d25bca
Le livre de Danah Boyd est paru
J’en ai déjà parlé ici : https://www.datassence.fr/2026/03/24/revue-data-du-mois-fevrier-2026/?highlight=boyd.
Le livre est paru – « Data Are Made, Not Found – A Story of Politics, Power, and the Civil Servants Who Saved the US Census ». : https://press.uchicago.edu/ucp/books/book/chicago/D/bo277581183.html
A lire, une référence.
https://zephoria.substack.com/p/todays-census-news-is-a-big-deal
https://www.theguardian.com/commentisfree/2026/sep/10/census-trump-congress
Le corps des défunts, des données aux enjeux économiques, politiques et opérationnels !
Quand les données s’attaquent même aux corps des défunts et cela devient un commerce !
Les données sur les décès font partie des statistiques publiques. Elles jouent un rôle important dans le domaine de la santé (voir en France https://www.cepidc.inserm.fr/ ).
Il y avait aussi la monétisation des héritages numériques, tels que les profils des défunts sur les réseaux sociaux. Voire la construction de profils de défunts via des IA – « l’industrie de l’au-delà numérique ».
Mais là on dépasse ces cadres, avec une concurrence économique d’entreprises sur la collecte et la reconnaissance de données biométriques de personnes décédées. Avec également des enjeux politiques, opérationnels (remplacement des défunts pour assurer une continuité de fonctionnement), sociétaux (faire son deuil), médico-légaux (tout le monde via un smartphone peut initier une autopsie), médicaux (chaînons dans le processus de dons d’organe), policier, en situation de conflits armés…
Où tout un écosystème, va collecter ces données, les mettre en valeur, commercialiser, les utiliser.
L’article est fascinant et met en lumière le rôle des données, les stratégies associées, les infrastructure de collecte nécessaires … les données touchent à tout, sont sans limites, même les corps de défunts sont un objet à dataifier !
Quelques extraits (traduction automatique) :
« Les représentations numériques des personnes décédées constituent des actifs clés et génèrent une valeur monétaire. Elles sont mobilisées pour l’identification des corps, un secteur concurrentiel.…
une technologie qui garantit un haut degré de certitude quant au décès, par exemple lors de conflits internationaux ou de catastrophes, ils mettent en place des infrastructures pour la gestion des dépouilles.…
La reconnaissance faciale a déjà été utilisée dans des situations d’urgence. L’interlocuteur de Face Forensics évoque le scénario d’un tremblement de terre : « Il pourrait y avoir des militaires, des policiers, des ambassades, des ambassadeurs sur place. Si certaines personnes décèdent, il faut les remplacer pour que le système puisse continuer à fonctionner.…
Plus tard, il établit un lien direct entre ce processus d’identification et la création de valeur politique. Leur solution a permis « 70 000 recherches. Chaque recherche pouvait être une identification ou un point de contrôle, la découverte d’un corps, afin de vérifier l’identité d’un combattant étranger volontaire. » Cela comprenait l’identification des corps de soldats russes morts « se faisant passer pour des Ukrainiens » (Clearview-i).…
Il cite : « Grâce à ce projet, la mobilisation des forces russes a été ralentie ; les Russes ne souhaitent plus s’engager dans l’armée. En partie à cause de ce projet. » Le fait que la technologie FRT de Clearview AI puisse désormais être achetée par le département de la Défense américain souligne une fois de plus la valeur biologique posthume complexe que produisent les données des corps des défunts.…
La police, par exemple, fournit des images de personnes vivantes et décédées issues des casiers judiciaires.…
car les technologies de reconnaissance faciale permettent d’identifier les personnes décédées et ainsi de permettre aux vivants de faire leur deuil et de poursuivre leur chemin. »
Article à lire, on y trouve la description et l’ambition de collecte de données de ces sociétés qui monétise la mort, l’exploitation des thanatotechnologies (voir Foucault), l’idée de biovaleur posthume dans l’idée de biopolitique de Catherine Waldby, de politique des données de nos corps…
Fascinant !
Source : https://journals.sagepub.com/doi/full/10.1177/20539517261461448
Avant de confier sa mort aux données (voir le thème précédent), les dangers de confier sa vie aux données…au risque d’être éliminé
Toujours aussi éclairant, l’article d’Hubert Guillaud – à lire.
On y retrouve la classique fausse croyance sur les données intrinsèquement fiables.
Avec des décisions lourdes qui reposent sur des données, dont le cycle de production n’est pas forcément fiable, ni la définition, ni la traduction, ni l’interprétation, jusqu’à considérer les faux négatifs et positifs comme des effets collatéraux à accepter (jusqu’où accepter cela ?).
Le tout réfléchi avec des choix de construction (non l’IA n’est pas autonome, elle repose sur des choix délibéré, des données embarquées avec leurs défauts, des architectures mises en place, des algorithmes décidés-réfléchis…).
Les données auraient plus de valeurs que ce qu’elles représentent.
A lire l’IA et les données sur le champ de bataille.
Extrait : « Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs… il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts… Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres»
Quelle est la valeur des données de santé ?
La question est aussi vieille que les données…
Le sujet est connu pour être glissant (on peut veut tout faire dire aux chiffres).
La valeur des données de santé est historiquement d’ordre clinique et administratif, et maintenant de plus en plus économique.
Comment on estime cette valeur économique ?
L’article explore cela (au niveau EU et l’Espace européen des données de santé).
Et montre que l’estimation n’est pas forcément fiable, incohérences, hypothèses biaisées, plausibilité surévaluée, quantifications non correctes, déformée par lobbying d’acteurs économiques ou politiques (industriels, cabinets de conseil, institutions publiques…), enjeux boursiers, spéculations sur l’avenir…
Et dans l’esprit de l’article d’Hubert Guillaud, la quantification tend à neutraliser et à dépolitiser les concepts, en éliminant la complexité et l’ambiguïté au profit d’une apparente clarté, précision et rigueur technique.
Les auteurs expliquent leurs parcours de retraçage des exercices de valorisation, leurs parcours d’obstacle (peu de transparence), les méthodes rencontrées.
« Lors de l’analyse des données, nous avons procédé à un codage selon trois questions directrices : (1) Qui produit ces rapports ? (2) Comment ces rapports cherchent-ils à établir la crédibilité des estimations ? et (3) Comment ces estimations sont-elles reprises dans d’autres textes ? «
NB : où pour l’avoir vécu de l’intérieur, les données soit disants probantes relèvent de quantifications fantaisistes !
A explorer – dans la conclusion de l’article : « L’élaboration des estimations aurait pu se faire autrement. Certains économistes travaillent avec rigueur, transparence et engagement sur la quantification de la valeur économique. Acemoglu (2025) , »
Source : https://journals.sagepub.com/doi/full/10.1177/20539517261473362
Autres liens (La guerre des données, rôles des data products dans une architecture, Donnée de surveillance, Données de surveillance, Trois types de goulot d’étranglement liés au données, La course à la collecte de données d’entraînement, L’éternel sujet de représentation du temps dans les données, Destruction des data centers … destruction des données, Reconstruire, refondre N fois une data platform au sein d’un S.I, L’Open Data Institute, Sir Tim Berners-Lee et l’ONU lancent une fondation de données, Data physicalisation)
1) La guerre des données
Couper la relation cyber-physique, les flux de données (le cas des pacemakers coupés de leur serveur).
2) Data product : Il n’existe pas de modèle de données idéal pour un produit de données. Seulement des questions pertinentes
L’auteur aborde les questions autour de la standardisation – interopérabilité et de la séparation de la couche physique (découplage pour gérer les évolutions).
Des questions classiques de qualité architecturale dans un S.I.
3) Donnée de surveillance
Toujours le phénomène Flock et même les camions poubelles deviennent des postes de surveillance.
Extrait :
« La ville de Dallas utilise des caméras dotées d’intelligence artificielle, installées sur les camions de collecte des ordures, pour attribuer des « scores de dégradation » aux habitations . L’objectif est clairement de faire respecter les normes d’urbanisme, ce qui implique d’infliger des amendes aux habitants des quartiers défavorisés. Des riverains mécontents ont exprimé leur mécontentement lors d’une réunion du conseil municipal.
Lors d’une réunion du conseil municipal de Dallas mercredi et sur les réseaux sociaux, certains habitants et internautes se sont interrogés sur l’utilisation potentielle de cette technologie. « Levez la main si vous avez un score de dégradation… Quelqu’un a-t-il déjà reçu son score ? » a demandé un habitant. « Pour ceux qui nous suivent, la chaîne locale NBC vient de révéler que les camions poubelles de notre ville sont désormais équipés de caméras de surveillance pointées sur votre maison . Oui, votre maison. »
Et l’analyse fouillée d’Hubert Guillaud – à lire comme d’habitude.
Avec la mise en lumière de la tension entre cela sert, protège et cela surveille nos vies (privées…).
4) Trois types de goulot d’étranglement liés au données
D’après l’auteur – extrait (traduction automatique).
« – Quantité de données. Vous avez besoin d’un volume plus important de données issues de la même distribution que celle dont sont issus vos échantillons actuels. Par exemple : davantage de données provenant de Wikipédia, ou plus d’environnements de programmation pour l’apprentissage par renforcement (RL) présentant un niveau de difficulté équivalent.
– Qualité des données. Vous avez besoin de données qui permettent d’acquérir les mêmes compétences que celles déjà présentes, mais qui illustrent ces compétences avec un niveau de qualité moyen supérieur. Par exemple : des solutions détaillées, étape par étape, à des problèmes mathématiques complexes — élaborées par des experts —, des environnements de programmation pour l’apprentissage par renforcement plus exigeants, ou encore le filtrage des données existantes pour en éliminer celles de faible qualité.
– Couverture des données. Il s’agit de données reflétant des connaissances et des compétences qui ne figurent pas encore dans le jeu de données. Par exemple : des informations sur l’utilisation de machines en milieu industriel, ou des trajectoires d’experts détaillant, étape par étape, la construction d’un modèle financier dans Excel (alors que vos données initiales ne montraient que les modèles finis, sans le processus ayant permis de les élaborer). »
Des sujets bien connus en qualité des données.
5) La course à la collecte de données d’entraînement
Après les data labelers (voir plus loin), les data humanoïdes.
La coquille, l’enveloppe, l’emballage, la camisole data comme vous-voulez aussi pour les robots !
Mecka AI, une startup qui collecte et analyse des données de mouvement humain pour entraîner des robots humanoïdes et d’autres systèmes robotiques, est sur le point de réaliser une nouvelle levée de fonds
Cette start-up rémunère des personnes pour qu’elles se filment en train d’effectuer des tâches quotidiennes – comme préparer du café ou réparer une voiture – à l’aide de capteurs corporels et de smartphones.
Et aussi XDOF, qui, selon TechCrunch, était sur le point de réaliser une nouvelle levée de fonds avec une valorisation de 1,2 milliard de dollars , ainsi que des plateformes de données humaines s’étendant au-delà des LLM, telles que Scale AI et Micro1 .
Le boom de la demande : https://techcrunch.com/2026/09/22/snorkel-ai-triples-valuation-to-3-5b-as-demand-for-ai-training-data-booms/
Les data workers d’organisent « L’Association des étiqueteurs de données (DLA) milite pour un traitement équitable, de meilleures conditions et une reconnaissance des étiqueteurs de données dans le monde entier, tout en faisant pression pour que les travailleurs soient au centre de l’élaboration des politiques et des réglementations. » – https://datalabelers.org/index.html
Les coulisses de la production de données – conditions de travail, risques, santé psychique, précarité…
Et un article assez complet qui date du mois de mai : https://techequity.us/2026/05/21/data-work-landscape-2/
Le marché des data brokers
Qui achète : https://themarkup.org/privacy/2026/09/16/whos-buying-your-personal-data-disney-gm-your-insurer-and-bank-heres-what-they-get … Qui achète vos données personnelles ? Disney, GM, votre assureur et votre banque. Voici ce qu’ils obtiennent. Avec une longue liste d’entreprises clientes d’Acxiom – https://www.acxiom.com/ . Et https://themarkup.org/privacy/2026/09/16/data-brokers-have-detailed-files-on-you-heres-whats-in-them-and-how-it-impacts-you – Les courtiers en données possèdent des dossiers détaillés vous concernant. Voici ce qu’ils contiennent et comment cela vous affecte.
6) L’éternel sujet de représentation du temps dans les données
On s’y est tous frotté (timestamp, date de début – date de fin, date d’effet, date de valeur, date de validité…)
Snowflake sort son type de donnée dédié.
Exemple :
« To make this concrete, let’s walk through an insurance policy management platform — a domain where temporal ranges carry legal and financial weight. Policies have validity windows. Claims have filing deadlines. Getting the boundaries wrong means a customer’s claim gets denied or a duplicate policy slips through.
The platform needs to answer five questions:
- Is this policy active on a given date?
- Does this customer have a gap in coverage?
- Do any active policies overlap for the same product?
- Which policies are approaching expiration?
- What is the intersection of two coverage windows? »
Le dépôt Github https://github.com/satishkumarai/snowflake-period-data-type-production et https://docs.snowflake.com/en/sql-reference/data-types-period
7) Destruction des data centers … destruction des données
Les risques de la guerre sur les données, les data centers des cibles stratégiques, des données sont détruites définitivement (où sont les sites backups ?).
Source :https://www.wired.com/story/customer-data-permanently-lost-in-iran-strikes-on-amazon-data-centers/
8) Reconstruire, refondre N fois une data platform au sein d’un S.I
Quel architecte n’a pas vécu cela (infocentre, DW/DM, hadoop, data lake, data lakehouse, data platform, IA data platform…) ?
Et cela continue !
« La plupart des plateformes de données disparaissent avant la cinquième année et la solution est ennuyeuse ».
Extraits : « Les équipes qui réussissent prennent trois décisions dès le départ : utiliser BIGINT pour chaque clé primaire et étrangère, sans exception ; concevoir un schéma évolutif (nouvelles colonnes, nouvelles tables), sans jamais renommer de colonnes ni modifier leur type en production ; et adopter un format de table ouvert qui gère nativement l’évolution du schéma. »
Et aussi l’observabilité, les métadonnées, la logique de data framework… dans les fondations.
9) L’Open Data Institute, Sir Tim Berners-Lee et l’ONU lancent une fondation de données
« Sir Tim Berners-Lee, cofondateur de l’Open Data Institute et inventeur du World Wide Web, a déclaré : « Les données sont le fondement de l’IA, et la concrétisation de ces opportunités dépend de la mise en place de bases solides. Les services publics peuvent exploiter la puissance des données au service de leurs citoyens, et s’ils le font, ils bâtiront un avenir où les bienfaits de l’IA profiteront à tous. » – https://www.datafoundationsforai.org/
Source : https://www.ukauthority.com/articles/odi-sir-tim-berners-lee-and-un-launch-data-foundation
10) Data physicalisation
Que se passe-t-il alors lorsque nous traitons les données comme une matière première pour la création ? Comment rendre les données tangibles ?
L’exercice toujours surprenant de physicalisation des données … pour mieux les comprendre, les penser, pour vivre une expérience ?
Déjà effleuré : https://www.datassence.fr/?s=physicalisation
Exemple : L’artiste Nathalie Miebach, par exemple, transforme des données météorologiques et écologiques en sculptures complexes – https://www.nathaliemiebach.com/work/stay-healthy-and-strong
RDV maintenant en novembre pour la revue et les actualités d’octobre.

Les commentaires sont fermés.