Cet été le choix de 5 sujets (activisme des données, un livre sur l’histoire et l’empire des données, architecture logicielle : les frameworks déclaratifs de données, le business de la production de données pour l’IA et dans la suite, le sujet récurrent des données pour l’IA).
Sinon, une liste de lectures au fil de l’eau.
A piocher en fonction de vos centres d’intérêt.
Sommaire :
- Activisme des données la force du quotidien
- La parution d’un livre intéressant qui retrace l’histoire des données et fini par une projection en 2126
- Quand la logique de framework déclaratif devient centrale pour les données
- Le business de la production de données pour l’IA … qui finiront par remplacer ceux qui les produisent !
- Agent data IA : Préparer vos données pour l’IA agentique
- Autres liens (la course sans fin aux données pour l’IA, Le graal historique de réunir transactionnel et décisionnel, Data et IA : LLM versus World model, Data et IA … et portabilité du contexte, Data empoisonnement)
Activisme des données la force du quotidien (article d’étude de pratiques en Corée du Sud)
L’idée de routinisation de pratiques au quotidien qui à force prennent collectivement une portée politique – reliées à un objectif collectif récurrent (à l’opposé d’opération coup de poing, hackathon…).
Exemple de pratique et travail sur les données :
- Collecter et transcrire des données, parfois à partir de documents PDF difficilement exploitables (des rapports, des notes de frais).
- Saisir des données de terrain.
- Nettoyer, structurer et enrichir des bases de données. Signaler des erreurs, contribuer à des bases communes et diffuser les résultats.
- Développer des moyens de data visualisation, de détection ou de consultation.
- Vérifier et corriger des data visualisation trompeuses.
- Tester les applications « activistes »
Pratique à inclure avec le moins de friction possible dans son quotidien tout en s’obligeant à rejoindre des actions collectives :
- Des petites contributions réalisées pendant les trajets, les pauses ou les courses, la lecture d’actualité, d’informations partagée dans les réseaux sociaux (exemple signaler une infographie suspecte dans l’actualité, transcrire des données).
- Des échanges réguliers sur Slack et GitHub.
- Des réunions hebdomadaires pour discuter, vérifier et améliorer les productions.
- L’apprentissage mutuel et la répartition souple des tâches (pas d’objectif de productivité)
- L’appel à des micro contributions sur Facebook et Twitter, invitant le public à signaler des produits (scan de codes-barres, vérification d’étiquettes) lors de leurs courses.
Exemples :
Agir sur les pratiques de consommation
Une application permet de scanner les codes-barres pour identifier les produits d’une entreprise ciblée par une campagne de boycott en raison de ses pratiques sociales.
Les consommateurs contribuent à enrichir la base de données en signalant des codes-barres manquants ou non reconnus.
Pratiques : constitution de bases, tests, enrichissement participatif et mobilisation par la consommation.
Contester les biais médiatiques
Corriger des graphiques de presse jugés trompeurs en reconstruisant des visualisations plus fidèles aux données.
Utilisation du web scraping pour repérer des titres potentiellement sexistes, que les membres analysent et reformulent collectivement avant publication.
Pratiques : veille, scraping, analyse critique, visualisation et diffusion publique.
Et aussi, le contrôle de frais, de subventions, de dépenses d’organismes publiques.
L’idée de fond : le collectif – réseau informel/formel – logique de pairs, récurrent, résilient, autonome, par petite touches comme moyen de contrer l’asymétrie dans la contrôle des données, avec en plus le sentiment de contribuer à une cause.
NB : l’idée a toute sa valeur également au sein des entreprises. Ou souvent les efforts sur les données sont par à-coup, par task force, volatiles, non ancrés durablement.
Source : https://journals.sagepub.com/doi/abs/10.1177/20539517261465305
Voir aussi dans la même idée : https://www.datassence.fr/2026/06/25/revue-data-du-mois-mai-2026/?highlight=activisme#_ftnref2
La parution d’un livre intéressant qui retrace l’histoire des données et fini par une projection en 2126
L’ouvrage : Data empire Par Roopika Risam (professeure agrégée de sciences humaines numériques)
Sous-titre : The Power of Information to Organize, Control, and Dominate
Editeur : https://www.harpercollins.com/products/data-empire-roopika-risam?variant=44401427513378
Un roman, un essai, l’histoire des données et comment elles ont pris autant d’importance. Et une conclusion : quand les citoyens ont repris le pouvoir par les données.
Projection en 2126 « Les données ne sont plus un outil de contrôle. Elles sont utilisées différemment, comme une ressource partagée, rendue possible par la technologie mais gérée dans la transparence et le choix collectif. »
La table des matières
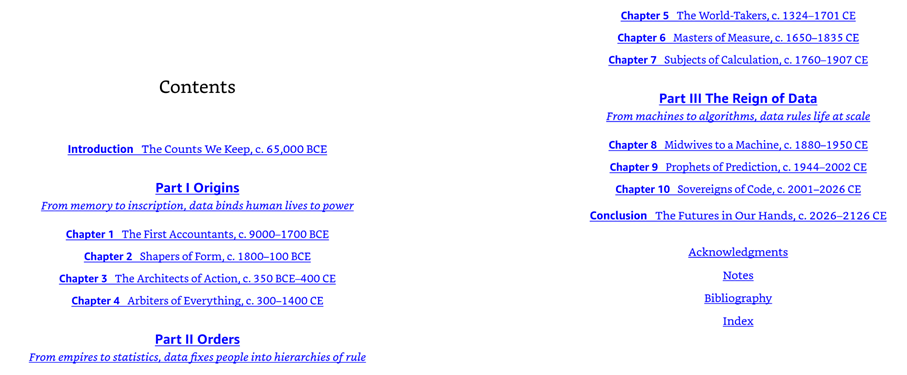
Source : https://bigthink.com/books/data-empire/
Quand la logique de framework déclaratif devient centrale pour les données
L’article : « Data Engineering’s Shift from Imperative to Declarative – and Why It Matters More in the Age of AI ».
Pourquoi c’est clé :
1) Cela remet en avant la logique de framework comme pattern d’architecture logiciel. Framework au sens capacité à faire évoluer les interactions et les briques d’un logiciel autour d’un core model. Par interactions on entend par exemple : la connexion à des sources de données, la publication multi-modal de données. Par briques : des composants de calculs de data sciences. Avec un core model support à l’exécution de pipelines de données, d’orchestration de ces pipelines, de gestion de schéma de données, de traçabilité – lineage – étiquetage des données…
2) L’idée central est de disposer d’une capacité d’évolution fonctionnelle contrôlée et surtout facilitée (j’ajoute des briques et le framework se configure automatiquement).
Et cela se fait de manière déclarative et non plus par coding au cœur du logiciel.
3) Avec l’arrivée de l’IA, la façon de réaliser cette déclaration évolue. On ne déclare plus l’ajout de telle ou telle brique, mais le résultat attendu et le système se charge de trouver comment y parvenir. Je veux être en mesure de récupérer telles données de l’ERP d’entreprise XXX. L’IA se charge de répondre à cela en s’appuyant sur la logique de framework. Elle ne vient pas modifier le framework, elle le « paramètre ». Ce qui permet de contrôle ce qu’elle produit versus l’affres des ingénieurs logiciels actuels perdus dans la maintenance de solutions produites par IA.
4) Appliqué aux données cela donne essentiellement une nouvelle façon de mettre en œuvre des pipelines de données (des sources en passant par des traitements, jusqu’à la restitution, tout en gérant des évolutions de modèles). Le framework se charge en plus de l’orchestration (fonction de son core model) Le coding est remplacé par du déclaratif. Exemple : Les contraintes de qualité des données sont déclarées dans la définition du modèle.
Source : https://bradcoles.dev/blog/declarative-transformation.html
Le business de la production de données pour l’IA … qui finiront par remplacer ceux qui les produisent !
Mais au vu de l’emprise de l’IA et ses perspectives, un business énorme.
Le cas Micro1 https://www.micro1.ai/ un CA brut qui passe de 100 Millions de $ à 500 Millions en 8 mois (NB Mercor https://www.mercor.com/ un concurrent a franchi le cap des 2 Milliards de CA brut).
Le principe : des données annotées par des spécialistes – mode Uber/travaux à la tâche (marge brute autour de 60%) + données synthétiques (marge brute autour de 90%) … beau business !
Avec des sujets géostratégiques, ces données sont-elles à vendre à tout le monde (Chine par exemple) ?
Et aussi une bataille dans le rachat de sociétés en faillite, uniquement pour récupérer leurs données (voir les exemples cités ici : https://www.presse-citron.net/une-compagnie-aerienne-vient-de-mourir-et-google-a-rachete-toute-sa-data/ et https://gizmodo.com/elon-musk-reportedly-seeking-customer-data-from-dead-startups-to-train-ai-2000813451)
Attention de mon avis, le cout de transformer les archives de données d’entreprise en données exploitables par l’IA n’est pas du tout simple. Entre interprétation, réglementations – exemple anonymisation, contextualisation, respect de la propriété des données (cas client, fournisseur…), contrôle qualité, cela risque de couter assez cher, même avec des moyens IA. Mais je ne doute pas que le business doit être rentable.
Sources : https://techcrunch.com/2026/08/20/ai-data-startup-micro1-reaches-500m-gross-run-rate-amid-ai-training-boom/ et https://www.hpcwire.com/bigdatawire/2026/08/25/ais-data-appetite-is-growing-micro1-just-hit-500m/
Agent data IA : Préparer vos données pour l’IA agentique
Un article complet.
Auteurs : Pramod Sadalage – https://sadalage.com/ et Prem Chandrasekaran https://premonition.dev/
Table des matières :

Le fond : que signifie – pour les données « prêtes pour l’IA ».
La qualité des données ne s’arrête pas à la mise en place de moyens techniques, elles a toujours fait appel à un œil humain, au moment de l’interprétation, de la vérification de la cohérence et de la fiabilité avec un contexte connu. Lorsque cet œil humain est remplacé par un agent IA, autour des données qui lui sont confiées tout un contexte et des taches doivent être spécifiées. Plus difficile, la confiance que cet œil pouvait accorder à des données ou aux résultats associés doit être intégrée dans le travail de l’agent. Ce qui était avant implicite doit être explicite.
Exemples : évaluer la fiabilité d’une données en toute connaissance d’un calendrier de collecte, de spécificités de collecte, de défauts de collecte… , tracer les choix effectués sur les données (écartées, « arrangées », ajoutées, reprises après envoi, comblées…), transformer l’interprétation des données en actions (jugement, décision, action).
Si l’agent de ne dispose pas d’une formalisation de ces éléments … il échouera avec assurance !
NB : dans mes retours d’expérience, un autre point clé, la part non déterministe laissée aux agents (appel à des fonctions LLM). Avec soit accepter les faux positif et négatif et / ou avec le résultat de devoir mixer le retour à des approches classiques déterministes (moteur de règles par exemple) avec une part réservée aux LLM. Au final le cout de mise en place d’un agent en production est toujours très très largement sous-évalué. Un autre point d’attention est le traitement du risque d’empoisonnement des données pour mettre à mal le fonctionnement des agents.
NB bis : attention aux illusions MCP – https://medium.com/the-leading-indicator/mcp-is-dead-1b24fe6a3e64 et évoqué précédemment https://www.datassence.fr/2025/05/21/revue-data-du-mois-avril-2025/?highlight=corba#_ftn5
Source : https://martinfowler.com/articles/making-data-ready-for-agentic-ai.html
Autres liens (la course sans fin aux données pour l’IA, Le graal historique de réunir transactionnel et décisionnel, Data et IA : LLM versus World model, Data et IA … et portabilité du contexte, Data empoisonnement)
1) Sources de données IA : toujours la course sans fin par les acteurs de l’IA à pourchasser la moindre donnée (dans des archives, dans l’ingurgitation du moindre ouvrages, de la moindre vidéo, dans des entreprises défuntes, via des données que vous avez confié et qui d’un seul coup vont être sources d’apprentissage…). Avec la question de la dimension éthique (est-ce du vol de données, voire plus du vol de travail… ?).
Sources :
Le cas Oxylabs – https://oxylabs.io/ (startup lituanienne) : web scraping solutions, collecte de données d’appareils grand public (175 millions d’adresses IP) – usage de proxies pour garantir l’accès (voire le contournement de dispositif anti-scraping). https://siliconangle.com/2026/07/09/web-data-scraping-infrastructure-startup-oxylabs-reels-130m-first-ever-funding-round/ et https://www.presse-citron.net/qui-est-oxylabs-la-nouvelle-licorne-europeenne-qui-traite-toute-vos-datas
Vue en septembre aussi : https://trends.levif.be/opinions/laffaire-anthropic-451/ (« Pourquoi l’IA passe-t-elle les livres à la guillotine ? Lancement de l’article : Cela commence comme dans un roman d’espionnage. Dans les premiers mois de 2026, quelques bouquinistes, un peu partout, de Brooklyn à Toronto, ont vu affluer des commandes pour le moins bizarres. Des guides juridiques périmés, des monographies pointues sur l’architecture de verre ou sur des sujets tels que les stations d’épuration des eaux usées partaient par dizaines comme des petits pains, achetés au prix fort par de mystérieuses sociétés répondant aux noms énigmatiques et exotiques de Green Parrot ou Red Sparrow… »).
2) Le graal historique de réunir transactionnel et décisionnel dans un même moyen de stockage : la proposition Databricks
NB : j’en entend parler depuis la fin des années 80 !
Sources :
Fuite IA de données par rebond : l’utilisation de l’IA de façon débridée, conduit à accentuer les risques de fuites de données par rebond. Je reçois des documents, des dossiers et je demande à une IA de m’aider à la lecture. C’est terminé, les données reçues peuvent potentiellement être récupérées (a minima par les moteurs d’IA) sauf à prendre des dispositions nouvelles.
Le cas des données partagées par les entreprises avec l’administration.
Source :
3) Data et IA : LLM versus World model
NB – un commentaire : c’est un axe de recherche pour dépasser les limites des LLM qui ne « comprennent » pas comment marche le monde. Ils n’ont que du texte pour référence (leur base d’apprentissage). Ils ne font que prédire le prochain mot d’une phrase en tenant compte d’un contexte (prompt et de milliards de références textuelles statistiques). Il ne prédisent pas en tenant compte de lois d’environnement (physique mais aussi comportementale). Les world model visent à cela. Prédire en « comprenant » des lois par apprentissage. Par exemple (simple) la gravité quel que soit le truc qu’on lance il retombe au bout d’un certain temps… sur Terre mais pas dans l’espace. L’apprentissage repose sur des milliards de comportements captés – expériences captées (rôle clé des capteurs) pour être capable de prédire que telle action a telle effet. C’est évidemment plus puissant en robotique mais pas que, cela s’applique à tout système dont on veut maîtriser le comportement (construire un système de lois par apprentissage). L’idée est de passer de l’absence de compréhension du monde (rappel 100% de ce qu’écrit un LLM sont des hallucinations et statistiquement cela tombe « juste » 80% du temps en terme d’intelligibilité parce que les textes d’apprentissage disent statistiquement des choses « juste ») à une compréhension causale et temporelle d’un environnement (physique, trading financier, biologie, logistique, attitudes humaines…). Avec une telle compréhension le world model peut prédire un nouvel état de l’environnement sans qu’il l’ait déjà rencontré avant et sans connaître les lois de l’environnement au départ (il les déduit de son apprentissage). On passe de prédire du texte à prédire le monde (prétentieux). On dit que l’avenir de l’IA est un mixte LLM et world model. Tout cela repose sur des données qui enferment notre monde et écartent ce qui n’est pas dataifiable et imposent un choix de formalisation en données. Bienvenue dans la matrice des données.
4) Data et IA … et portabilité du contexte
Quand le manque de portabilité du contexte représente une menace à long terme.
Ou autrement dit quand la migration de données doit se préoccuper de la migration du contexte associé (Extraits – traduit « la signification de vos données doit être liée aux données elles-mêmes, et non à l’outil dans lequel elles sont configurées… Le schéma sous-jacent est toujours le même. Une entreprise compte déjà des agents travaillant sur quatre ou cinq plateformes différentes…Auparavant, lorsque deux tableaux de bord divergeaient, quelqu’un finissait par ouvrir un ticket. Des discussions avaient lieu. Une remontée d’information était nécessaire. Le désaccord était visible. En revanche, lorsque deux agents sont en désaccord, personne ne s’en aperçoit…»).
Données et surveillance : chaîne de courtage de données, la soif de centralisation des sources de données
http://www.techdirt.com/2026/07/23/ice-illegally-scooped-up-medicaid-data-then-shared-it-with-palantir/ (« ICE Illegally Scooped Up Medicaid Data, Then Shared It With Palantir »)/
… et tentative de contre-pouvoir https://gizmodo.com/a-feature-that-makes-your-phone-data-self-destruct-in-authorities-hands-may-soon-have-its-day-in-court-2000790831 (« A Feature That Makes Your Phone Data Self-Destruct in Authorities’ Hands May Soon Have Its Day in Court »). Illégal de détruire ses données ?
5) Data empoisonnement
RDV maintenant en octobre pour la revue et les actualités de septembre.

Les commentaires sont fermés.